一,向量数据库和传统数据库的区别是什么?
1,存储方式不同:
传统数据库存储的信息是原始信息数据;
向量数据库存储的数据是:通过向量模型将原始数据转换成相应的数字,或者说数学特征。
2,数据查询方式不同:
传统数据库是按照条件进行精确查询,向量数据库是按照语义相似度进行查询;
3,应用方向不同:
传统数据库通常用于业务数据的存储和精确查询;
向量数据库通常用于RAG、知识库问答,以图搜图等应用或功能;
二,AI的记忆是怎么理解的?Agent的记忆。
1,AI没有记忆;
2,Agent的记忆可分为三层:
第一层是提示词和指令,定义 Agent 的角色和规则、需求(多轮对话记忆也算);
第二层是上下文或工作记忆,保存当前任务的信息和执行状态(例如计划文档等);
第三层是长期记忆,保存用户偏好、企业配置和历史经验等跨会话信息。
提示词决定“怎么做”,上下文记忆决定“现在做到哪了”,长期记忆决定“以前记住了什么”。
三,RAG了解吗?
内部学习链接:
https://www.iashes.com/2026/08/21-8216.html
(1),RAG中已经有了向量检索,为什么还需要关键词检索(全文检索)?
RAG 加关键词检索,是因为向量检索虽然擅长语义理解,但对编号、金额、日期等一些其他专有名词不一定能够理解,或不能够精准地理解。所以需要关键词检索进行匹配,两者结合可以同时兼顾语义召回和精确召回,提高召回率,提高检索的准确率和覆盖率。
(2),如果一个文件新增了内容,RAG如何做版本或者新内容的更新?
「方法1」,直接删除旧文件的源文件和向量数据,然后将新文件导入到RAG中;
「方法2」,覆盖掉旧文件,然后导入新文件,对新文件重新进行文档解析、源数据生成、脏数据的清洗、chunk、再进行向量化、建立索引。
覆盖后,根据旧文件的路径,判断是否是旧文件的新版本,源数据中会记录一个新的版本。
用户提问的时候,LLM先去理解,获得问题中所需的版本号,根据版本的条件再进行向量检索和关键词检索。类似于传统数据库中:
SELECT * FROM chunks WHERE status = ‘active’ AND version = ‘1.1’
四,提示词工程和上下文工程了解吗(Prompt Engineering和Context Engineering)?
提示词工程:
提示词工程,主要是设计提示词内容,如何让大模型能够更清晰的知道用户的意图。
核心是设计设计input中的:System/Developer Prompt + User Prompt,把任务、规则、背景、限制、输出格式说清楚。
通常需要对于任务、规则、背景、限制、输出格式整理清楚给到大模型,可能还有有协议验收标准、测试标准也需要给答模型。
Input是给到模型的输入,通常是System > Developer > User,这三个input的内容规则通常是:
System / Developer = “这个 AI 平时应该怎么工作”
User = “这一次我要你做什么”
通常大模型之后:System + User 或者 Developer + User,一些新的模型规定,去掉了System,用Developer替代了。
System Prompt通常输入的信息是:角色、行为规则、业务规则、输出要求、边界条件。例如:
# System Prompt
你是一个销售分析助手。
必须基于事实回答。
不要编造客户信息。
输出必须包含:结论、原因、下一步建议。
User Prompt,通常输入的信息是:当前任务、当前输入数据、用户临时要求,例如:
# User prompt

请分析这个客户今天是否值得重点跟进。

客户资料:
公司规模 200 人
预算 30 万
最近沟通表示正在对比竞品


# 给到大模型的整体提示词如下:

[
  {
    "role": "developer",
    "content": "你是销售分析助手。不要编造信息。输出结论、原因和建议。"
  },
  {
    "role": "user",
    "content": "请分析这个客户:..."
  }
]
所以,提示词工程:
Prompt Engineering = 设计“指令”
主要是:
System / Developer Prompt
User Prompt
任务要求
规则
输出格式
示例
提示词工程也是上下文工程的一部分。
上下文工程:
上下文工程(Context Engineering)的输入,其实就是设计“模型这一轮能看到的全部信息”,这些全部信息包括:
历史对话、RAG 检索资料、Memory、工具定义、工具返回结果、当前状态、外部数据等等。
所谓上下文,其实就是告诉模型,我需要实现某一个需求(提示词工程中的任务),能给到你哪些信息。
四,Agent和工作流的区别是什么?
Workflow(工作流)是:任务怎么执行,主要是人/代码提前规定好,按照明确的流程节点执行。
Agent(智能体)是:告诉它指令、要求或任务验收标准,它自己判断下一步怎么执行,调用什么工具,直到任务完成或达到验收标准。
Agent中的下一步执行是由LLM进行理解和判断的。
Workflow的执行顺序和节点,是程序搭建好的节点,任务的执行是按照搭建好的节点按流程进行执行;
Agent的执行顺序是不固定的,节点的个数也是不确定的,根据当前任务已经每个节点的执行后的上下文环境LLM再去规划下一步的节点。所以Agent是一个循环(loop),循环的目标就是完成当前任务,且循环的结束条件也是任务完成才结束当前agent的任务。
备注:
1,Workflow和Agent,都是可以在某一个节点调用大模型,当前Agent是必须调用大模型;
2,可以将Agent理解成一个能够干活的员工,下发一个任务,直到它完成为止;
什么时候使用Workflow、什么时候使用Agent?
1,当流程固定、任务规则清楚、明确的时候,使用Workflow,整个过程稳定、可控且成本低;
2,当流程不固定、任务规则模糊的时候,使用Agent,它比较灵活、能处理模糊和复杂问题,但是成本高,包括时间成本和token成本;
混合:
大多数情况下,一个Agent中会混合Workflow去完成一些任务,有一些需要推理或者思考的节点,使用Agent进行处理,明确的流程或者规则, 则用Workflow,这是让Agent工作成为Workflow工作的一个节点。
当然,Workflow也可以成为Agent的一个节点,根据业务的不同,两者是相辅相成,搭配使用的。
Agent的大体流程可以理解成:
指令 → LLM → runtime监听 → 调工具 → 回传结果 → 再循环
引用Anthropic 官方的一句话:Workflow 是让 LLM 和工具沿着预定义的代码路径运行;Agent 则让 LLM 动态决定自己的过程以及使用什么工具。
五,agent导致上下文太长,模型可能会出现幻觉,这个如何避免?
目前对于上下文压缩,最常见的压缩维度和方法:
截断:只保留最近 N 轮,或最近 N 个 token。
摘要:把早期对话压缩成一段摘要,作为 system 或一条 assistant 消息放进去。
向量检索:把久远的历史存起来,需要时用 embedding 检索相关片段再拼进 messages。
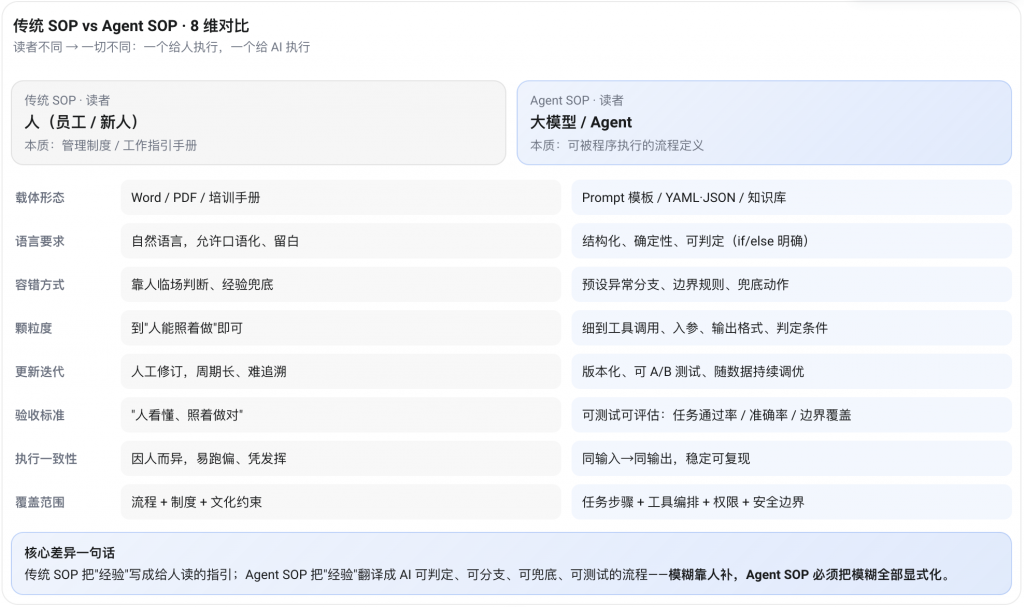
六,Agent SOP / AI SOP 和传统SOP的区别?
Agent SOP,把人类工作的标准作业流程(SOP, Standard Operating Procedure),改造成能让大模型 / Agent 稳定、按步骤执行的标准化流程。
区别:
传统 SOP 的读者是 “人”,靠人理解执行;Agent SOP 的读者是 “大模型 / Agent”,必须写成程序能解析、能判定、能兜底的结构化定义。
七,KV Cache